动作模仿:一张人像 + 一段动作视频,让静态角色动起来
摘要:这个页面只做一件事——把一段真实拍摄的动作,迁移到你指定的人像上。人物图决定"谁在动",动作视频决定"怎么动"。素材要求、参数、积分消耗都不高,属于上手最快、出片最直观的一档。
一、核心逻辑:两张素材,一个结果
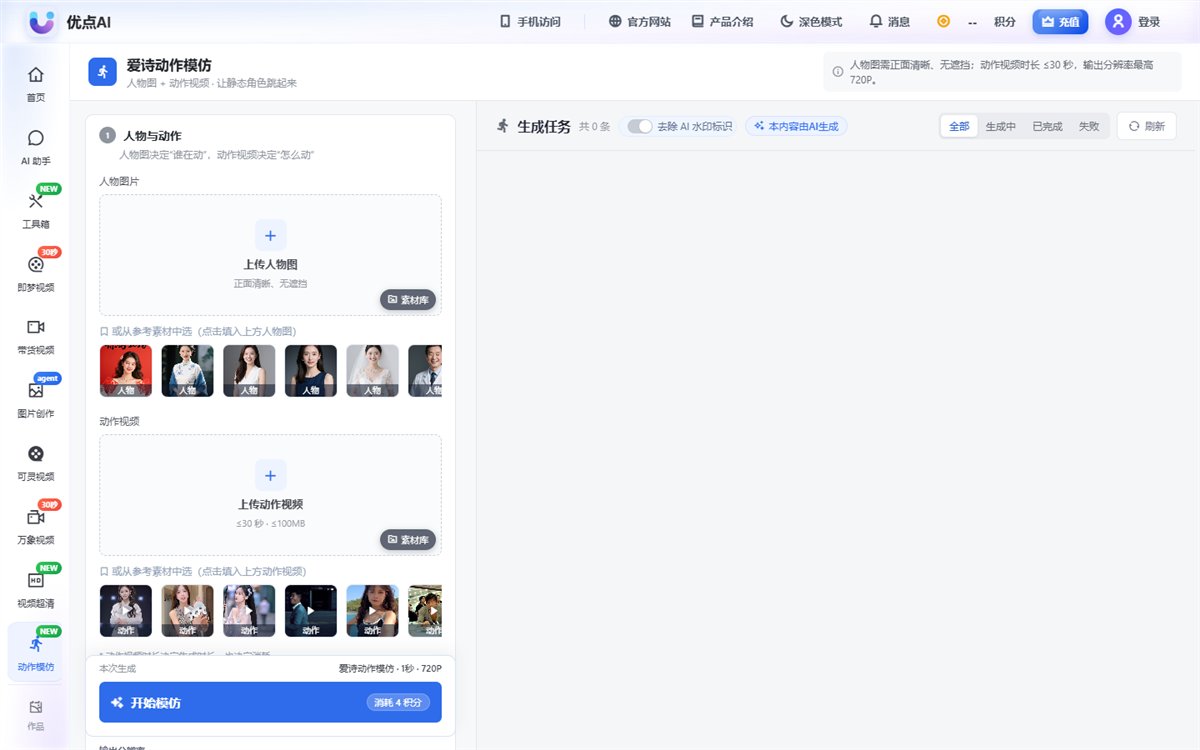
页面标题下方一句话把原理说透了:人物图决定"谁在动",动作视频决定"怎么动"。所以它不是文生视频,也不需要写提示词——你给什么素材,它就输出什么动作。
- 人物图:需要清晰、无遮挡。下方还给了 6 张参考人像,也可以从素材库调用已生成的形象;
- 动作视频:时长 ≤ 30 秒、体积 ≤ 100MB,输出分辨率最高 720P。
这两个限制直接决定了工作流:先在 30 秒内剪出想要的那段动作,再有针对性地出片。
二、参数与消耗
当前档位显示:爱诗动作模仿 · 1 秒 · 720P,单次消耗 4 积分。这是整个视频体系里最便宜的一档——因为输出时长由动作视频决定,不需要模型自己规划镜头。
换句话说:它不贵是因为它不做创作,只做迁移。想清楚这一点,就不会拿它当"视频生成器"用。
三、任务列表与 AI 标识
右侧是任务区,顶部写着「生成任务 共 0 条」,可按全部 / 生成中 / 已完成 / 失败筛选,右侧有刷新按钮。任务提交后可以继续编辑参数,进度会实时刷新。
任务区上方还有两个开关:去除 AI 水印,以及「本内容由 AI 生成」的合规标识。前者是付费能力,后者是上线必须——两个都要在后台配置好。
四、适合拿来做什么
- IP 形象动态化:把做好的角色三视图里的一张,套一段走路/挥手动作,做成动态头像;
- 电商模特换动作:同一张模特图,套不同 pose 的动作视频,一次生成多条素材;
- 口播数字人的动作补充:数字人讲完内容后,需要一点肢体动作时用它补镜头;
- 表情包与短视频空镜:动作片段 1–3 秒,循环播放效果很好。
五、素材踩坑清单
- 人像侧脸或大角度倾斜,动作迁移后脸会崩——尽量用正面;
- 动作视频里有剧烈遮挡(手挡脸、物体穿过),结果会跟着"糊";
- 背景太杂乱时,模型会把背景一起迁移,尽量选干净背景的动作素材;
- 超过 30 秒的视频需要先剪,直接用长视频不仅不被接受,也会让结果不稳定。
六、和数字人能力的区别
数字人解决的是"说"——给定文案,输出口播视频;动作模仿解决的是"动"——给定动作,输出肢体。两者可以串起来用:数字人负责讲解,动作模仿负责补几个肢体镜头,一个完整的口播视频就成型了。